G検定のディープラーニング・数理統計対策
連載「G検定 攻略シリーズ」の第9回です。第1回で紹介したとおり、この連載はG検定の合格・不合格体験記52件を読み込み、JDLA(日本ディープラーニング協会)の公式情報と突き合わせて、合格に効くやり方を整理しています。
前回の法律・倫理に続き、今回は技術分野の難所を扱います。体験記で苦手・難所として名前が挙がるのは、ほぼ決まって ディープラーニングの3分野(概要・要素技術・応用例) と 数理・統計 です。この2つを、なるべく少ない時間で「落とさない分野」にする方法をまとめます。
私たちは資格の問題集アプリ「ナレッジバンドル」を作っていて、G検定の500問を分野(カテゴリ)ごとに分けています。本番形式テストのあとに弱点のカテゴリをグラフで出しているのは、この2分野のように苦手が偏りやすいところを、本番の前に見つけておいてほしいからです。
技術分野はシラバスでどう分かれているか
G検定の出題範囲は「Gシラバス2024」です。2026年5月11日の第1.4版が最新で、技術分野は大分類8つ・中項目37個に分かれています(JDLA G検定 シラバス)。
- 人工知能とは(中項目2)
- 人工知能をめぐる動向(4)
- 機械学習の概要(4)
- ディープラーニングの概要(6)
- ディープラーニングの要素技術(9)
- ディープラーニングの応用例(9)
- AIの社会実装に向けて(2)
- AIに必要な数理・統計知識(1)
数えてみると、技術分野37項目のうち 24項目がディープラーニングの3分野 に入っています。一方で、数理・統計は中項目が 1つだけ です。
ただし、分野ごとの問題数や配点は公式には公表されていません。「項目が多い=問題が多い」とは言い切れないので、ここでは「覚える範囲の広さ」の目安として見てください。
体験記で難所に挙がったのは「DLのモデル名」と「数理・統計」
2026年5月に会場試験で合格したGMOペパボの たてけん さんは、ディープラーニングの応用例について、「この手法はどの分野で何をするものか」を選べるかが問われると整理したうえで、こう書いています。
「個人的に、ここが一番大変でした。」
理由は、登場するモデルや手法の数が多く、「暗記量も他の分野より明らかに多い」ことでした。
2026年3月に合格した atchy さんも、「〇〇Netなどの似たような名前や英3文字の略称(CECやCTCなど)が山ほどあり」、なかなか記憶が定着しなかったと振り返っています。
数理・統計を苦手に挙げる人も目立ちます。2026年7月に合格した うめか さんは、ディープラーニングの概要・応用と数理統計が苦手だと気づき、数理統計については「何をどうやろうとも全くわからず、最終的には諦めました」と書いています。それでも合格しています。
合格者3人の分野別得点率
分野別の得点率を本文に書いている合格者のうち、Gシラバス2024の回で受けた3人の数字を並べました。
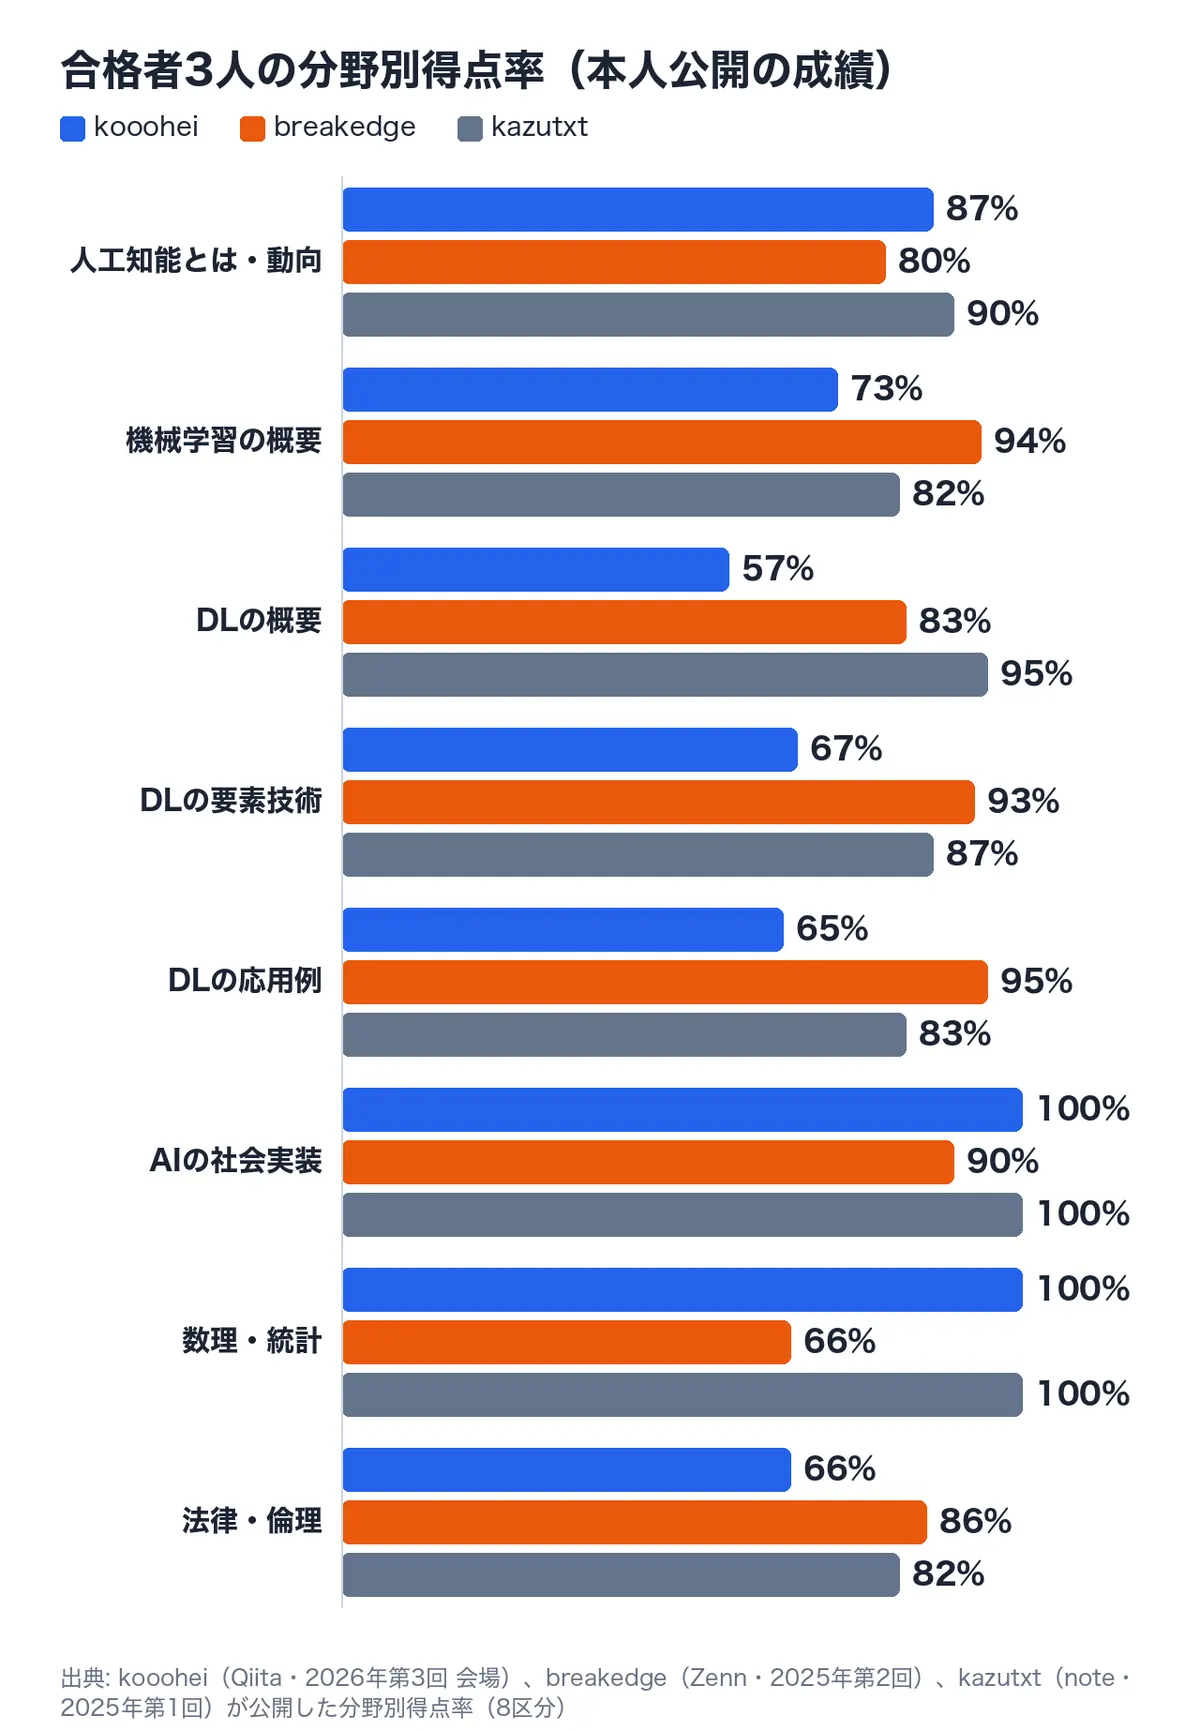
この図から読み取れることは3つあります。
- 苦手な分野は人によってまったく違う。 kooohei さん(2026年第3回・会場)はディープラーニングの3分野が57〜67%でしたが、breakedge さん(2025年第2回)は同じ3分野が83〜95%でした。
- 数理・統計は「満点」か「穴」かに分かれやすい。 3人のうち2人が100%で、breakedge さんは66%でした。
- どこかが低くても、ほかで取れば合格できる。 kooohei さんはディープラーニングの3分野が低くても、社会実装と数理・統計の100%で支えて合格しています。本人も「メインとなる技術分野は微妙な表現も多く」、理解があいまいな問題では苦戦したと書いています。
なお、3人が公開している分野別得点率は8区分で、シラバスの大分類1と2、法律と倫理がそれぞれ1つにまとめられた形になっています。
自分の穴がどこにあるかは、本番の前に知っておきたいところです。いちばん確実なのは、通しで解いて分野ごとの結果を見ることです。冒頭で触れたとおり、私たちのアプリでは本番形式テストを終えたあとに、いまの合格率と弱点カテゴリをグラフで確認できます。苦手と分かった分野は、「間違えた問題だけ」に絞って解き直していけば、限られた時間を穴埋めに集中できます。
ディープラーニングは「構造」と「用途」の2軸で区別する
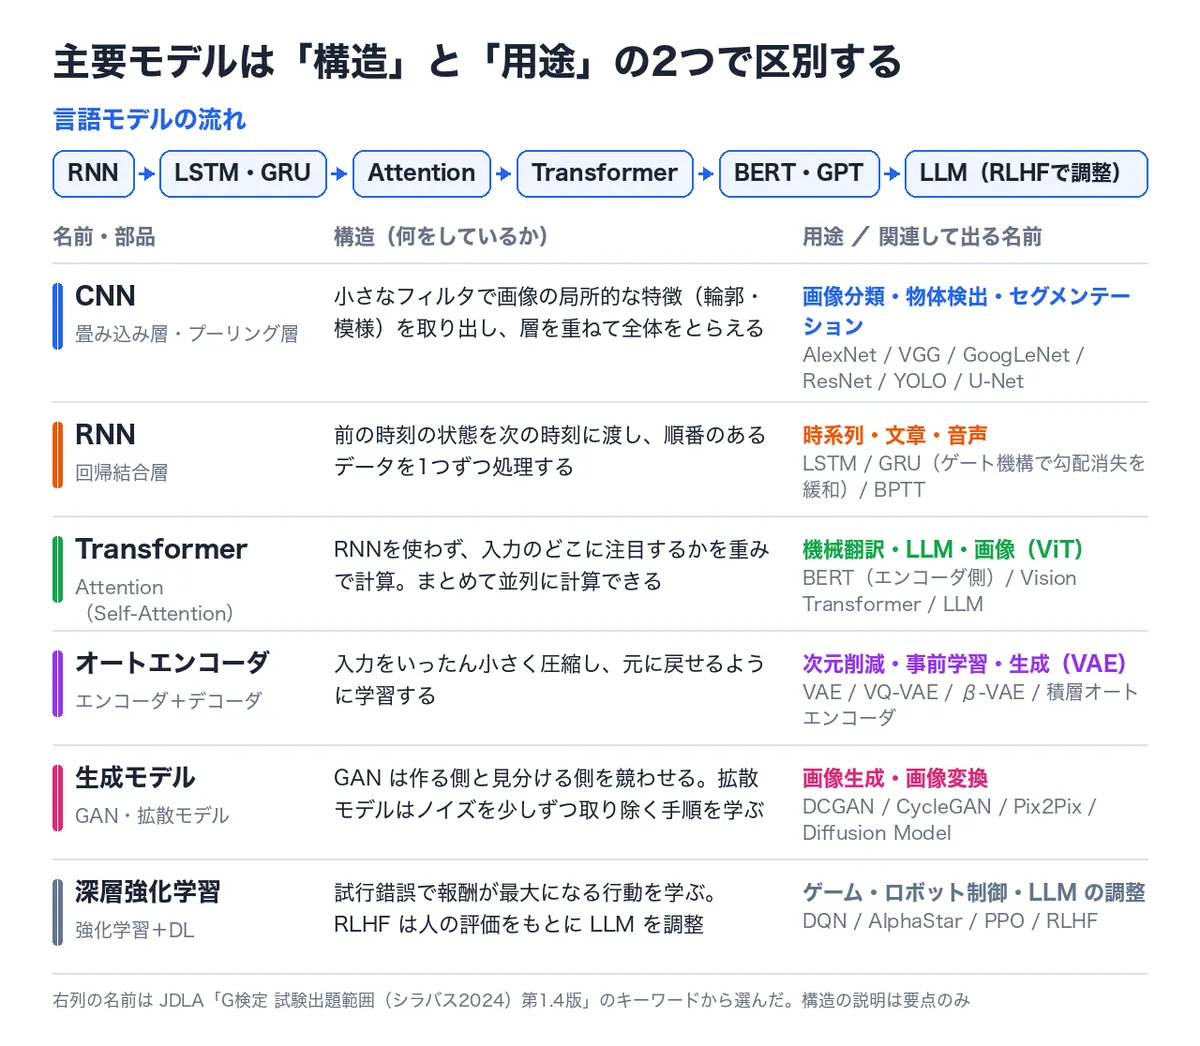
モデル名を1つずつ暗記しようとすると、数が多すぎて定着しません。先に 「どんな構造(部品)で」「何のデータに使うか」 という箱を作り、モデル名をその箱に入れていくと、選択肢の見分けがぐっと楽になります。
CNN:画像の「近くの画素」をまとめて見る
CNN(畳み込みニューラルネットワーク)の中心は、畳み込み層とプーリング層です。小さなフィルタを画像の上で少しずつずらしながら、輪郭や模様のような局所的な特徴を取り出します。層を重ねるほど、より大きな形をとらえられるようになります。
用途は画像分類・物体検出・セグメンテーションです。とても深いネットワークを学習しやすくした ResNet の「スキップ結合」も、シラバスでは要素技術の独立した項目になっています。
RNN・LSTM:順番のあるデータを1つずつ処理する
RNN(リカレントニューラルネットワーク)は、前の時刻の状態を次の時刻に渡しながら、時系列・文章・音声のような順番のあるデータを処理します。弱点は、系列が長くなると学習がうまく進まなくなる勾配消失です。
これを「ゲート機構」で和らげたのが LSTM と GRU です。LSTM の内部で情報を保ち続ける仕組みが CEC で、atchy さんが挙げた略語の1つです。
Attention と Transformer:RNNの弱点を「注目」で補う
シラバスの目標には「リカレントニューラルネットワーク(RNN)の問題点をAttentionはどのように解決できるか説明できる」とあります。ここが比較問題の中心です。
Attention は、入力のどの部分に注目するかを重みとして計算する仕組みです。Transformer は RNN を使わずに Attention(特に、文の中の単語どうしの関係を見る Self-Attention)で系列を扱うため、1つずつ順番に処理する必要がなく、まとめて並列に計算できます。そのままでは語順の情報が失われるので、位置エンコーディングで補います。
BERT は Transformer をもとにした事前学習モデルです。こうした Transformer ベースのモデルを大規模にしていった先に、LLM(大規模言語モデル)があります。画像に Transformer を使ったのが Vision Transformer です。
オートエンコーダと生成モデル
オートエンコーダは、入力をいったん小さく圧縮し、元に戻せるように学習する構造です。次元削減や事前学習に使われ、潜在変数を確率分布として扱う VAE(変分オートエンコーダ)は生成にも使えます。
画像生成の代表は GAN と拡散モデルです。GAN は「本物そっくりのデータを作る側」と「本物か偽物かを見分ける側」を競わせて学習します。拡散モデルは、データにノイズを少しずつ加える過程の逆、つまりノイズを少しずつ取り除く手順を学ぶことで、ノイズから画像を生成します。
LLM と RLHF
RLHF(人間のフィードバックによる強化学習)は、シラバスでは「深層強化学習」の項目に入っています。人が出力を評価したデータをもとに、LLM の出力を人の好みや意図に沿うように調整する方法です。LLM の話だから自然言語処理の項目だろう、と思い込むと分類を取り違えやすいところです。
似た名前・略語は「用途の箱」に入れて覚える
atchy さんが困った「〇〇Net」は、用途ごとに分けると整理しやすくなります。名前はすべてシラバスのキーワードにあるものです。
- 画像分類: AlexNet、GoogLeNet、ResNet、DenseNet、SENet、EfficientNet
- 軽く速く動かす(スマホ向けなど): MobileNet(Depthwise Separable Convolution で計算量を減らす)、MnasNet
- セグメンテーション(画素ごとの分類): U-Net、SegNet、PSPNet
- 音声の生成: WaveNet
英字の略語も、同じように「どの分野の言葉か」を先に決めます。
- CEC: LSTM(回帰結合層)の記憶の仕組み
- CTC: 音声認識。音声の長さと文字列の長さが違っても対応づけて学習する方法
- GAP: CNN のプーリング(グローバルアベレージプーリング)
- MFCC: 音声の特徴量(メル周波数ケプストラム係数)
- NAS: ネットワークの構造そのものを自動で探す方法(Neural Architecture Search)
覚え方のコツは、1つの名前に「箱(用途)」と「ひと言の特徴」を必ずセットにする ことです。第7回で紹介した生成AIの使い方で、「このモデルを用途とひと言の特徴で説明して」と頼み、問題の解説や用語辞書の説明と照らし合わせてから暗記カードにするのも効率的です。
覚えた箱が本番で使えるかどうかは、問題を解いて確かめるのが早道です。ナレッジバンドルでは、解説に出てくる用語をタップすると専用の用語辞書が開くので、どの分野の言葉だったか迷った略語をその場で引き直せます。忘却曲線にそって復習の問題が自動で出るので、一度覚えた略語を忘れかけたころに、もう一度確かめることにもなります。
数理・統計は「範囲が狭い」ことを利用して割り切る
数理・統計は中項目が1つだけで、シラバスのキーワードも一覧で確認できる量です。平均・中央値・最頻値・分散・標準偏差、相関係数・共分散・偏相関係数・疑似相関、正規分布・二項分布・ベルヌーイ分布・ポアソン分布、条件付き確率・期待値、最小二乗法・最尤法、帰無仮説・対立仮説、ユークリッド距離・マハラノビス距離・コサイン類似度などです(JDLA G検定 シラバス)。
目標には「基本的な統計情報を計算できる」とあり、計算問題も出ます。会場試験では電卓を持ち込めず、画面上の電卓を使います(JDLA FAQ)。
体験記を見ると、この分野への向き合い方ははっきり分かれます。
- 満点を取った人:kooohei さん、kazutxt さん(どちらも100%)
- 割り切った人:2026年3月に合格した たかなし さんは、「計算問題は「捨てよう」と割り切っていました」と書き、結果について「特に数理・統計分野が低すぎます」と振り返っています。それでも合格しています
- 分野ごとあきらめた人:前出のうめかさん(数理統計を諦めて合格)
ここから言えるのは、数理・統計を丸ごと捨てても合格した人はいるが、範囲が狭いぶん、少しの準備で満点も狙える ということです。おすすめの割り切り方は次の3段階です。
- 言葉の意味で答えられる問題は必ず拾う。 帰無仮説と対立仮説、疑似相関、外れ値に強いのは平均より中央値、などは暗記だけで解けます
- 計算問題は後回しにして★を付ける。 計算問題を全部後回しにし、迷った問題にはフラグを付けて見直した合格者もいます(Rcat999)。1問41秒の試験で、計算に数分使うのは損です
- 捨てるなら「計算だけ」にする。 分野ごとの配点は非公開なので、分野丸ごとを捨てると、どれだけ失点するかが読めません
2024年の改訂で増えた言葉・消えた言葉
使っている問題が今の範囲に合っているか、どのキーワードに時間をかけるかを判断するときは、シラバスの改訂内容も見ておきましょう。シラバスの改訂履歴には、Gシラバス2024で追加・削除されたキーワードの例が公式に載っています(JDLA G検定 シラバス、JDLA 2024年5月14日)。
- 追加の例: LLM(大規模言語モデル)、MSE・RMSE・MAE、Contrastive Loss、カルバック・ライブラー情報量(KL)、連鎖律、レイヤー正規化、エルマンネットワーク、教師強制、Multi-Head Attention、VQ-VAE・info VAE・β-VAE、話者識別、RLHF、Diffusion Model、NeRF、自己教師あり学習、破壊的忘却 ほか
- 削除の例: ENIAC、ロジック・セオリスト、第五世代コンピュータ、深層信念ネットワーク、パターン認識、OCR、IoT、クラスタ分析、制限付きボルツマンマシン、プラトー、ジェネレータ、ディスクリミネータ、Parts Affinity Fields、シリアス・ゲーム ほか
その後の版でも細かい見直しが続いています。2025年5月の第1.3版では単回帰分析や SARSA などが追加され、2026年5月の第1.4版では自然言語処理のキーワードから「ChatGPT、GPT-n」が削除され、「破壊的忘却」は「破滅的忘却」に表記が変わりました。
改訂前の版の教材には、深層信念ネットワークや制限付きボルツマンマシンの説明にページを割いたものがあります。逆に、拡散モデルや RLHF などの新しい言葉は、たてけんさんが書いているように、参考書でも詳しく解説されていないことがあります。Gシラバス2024に合わせて作られ、新しいキーワードも問題と解説で扱っている教材を1つ選ぶ のが確実です。そうした教材なら、新キーワードも問題を解きながら解説と用語辞書で押さえられるので、本を何冊も買い足して補う必要はありません。
まとめ:DLは「箱」で、数理・統計は「範囲の狭さ」で攻める
- 技術分野37項目のうち24項目がディープラーニング。モデル名は 「構造」と「用途」の箱 に入れて覚える
- CNN は画像、RNN・LSTM は順番のあるデータ、Transformer は Attention で並列計算。RNNとTransformerの違い は必ず説明できるようにする
- 〇〇Net と英字略語は 「用途+ひと言の特徴」 をセットにする
- 数理・統計は中項目1つ。用語問題は拾い、計算は後回し。捨てるなら計算だけ
- 苦手な分野は人によって違う。模試の分野別の結果で、自分の穴を見つける
次回は連載の最終回です。不合格体験記8件から落ちた原因を分析し、再受験割引の使い方と、試験直前1週間・前日・当日のチェックリストをまとめます。
G検定の500問をアプリで解くなら「ナレッジバンドル」
資格対策アプリ「ナレッジバンドル」には、G検定のオリジナル問題500問がすべて入っています。スキマ時間に1問ずつ解いて、間違えた問題だけを繰り返せます。
- 全問に解説つき。解説の用語はタップでG検定専用の用語辞書が開き、関連用語もたどれる
- 解説を読んでも引っかかったら、その問題をそのままAIに質問。Google検索もワンタップ
- 忘却曲線で復習を自動出題。「間違えた問題だけ」「未回答だけ」「ランダム」など出題の絞り込みも自由
- 本番形式テストで、いまの合格率と弱点カテゴリをグラフで確認
- 広告なし。全教材は無料体験できます
G検定のほか、100以上の資格・検定(レビュー中含む)が1つのアプリで使い放題です。アプリ内の教材追加画面で「G検定」と検索してください。
※この記事は2026年9月24日時点の公開情報をもとにしています。試験の制度や日程は変わることがあるので、受験前に必ずJDLA公式サイトで確認してください。体験記の引用は各記事の原文から行い、リンク先に出典を明記しています。