G検定の法律・倫理対策:著作権・個人情報・ガイドライン
「G検定 攻略シリーズ」の第8回です。この連載では、第1回で紹介したとおり、合格・不合格の体験記52件を読み込み、JDLAの公式発表と突き合わせて対策を整理しています。
今回は、技術の勉強に時間を取られて後回しになりがちな 法律・倫理の分野 を扱います。体験記には、この分野について次のような声がありました。
合格した人の中にも、法律や社会課題への応用の対策が足りなかったこと(Avinton)や、法律・倫理の対策が手薄だったこと(KIYONO Engineer Blog)を反省点に挙げている人がいます。
なお、分野ごとの配点や出題数は公式には公表されていません。「法律・倫理の比重が増えた」という話も、JDLAの公式発表で確かめられるのは「範囲を追加・明確化した」ところまでです。ここで紹介するのは、あくまで受験者の体感です。
この記事では、法律の説明はすべて官公庁の一次資料(文化庁・個人情報保護委員会・経済産業省・e-Gov法令検索)で確認し、出典を付けています。
私たちは資格の問題集アプリ「ナレッジバンドル」を作っていて、G検定の500問すべてに、正解の理由と各選択肢の正誤の解説を付けています。法律・倫理のように問題文と選択肢が長く、読み違えやすい分野ほど、ほかの選択肢がどこで誤りなのかを確かめられるかどうかで差が出ます。
法律・倫理の分野は「中項目18」でできている
現行のGシラバス2024では、10ある大分類のうち2つが法律・倫理の分野です。中項目は、技術分野の37とは別に18あります。
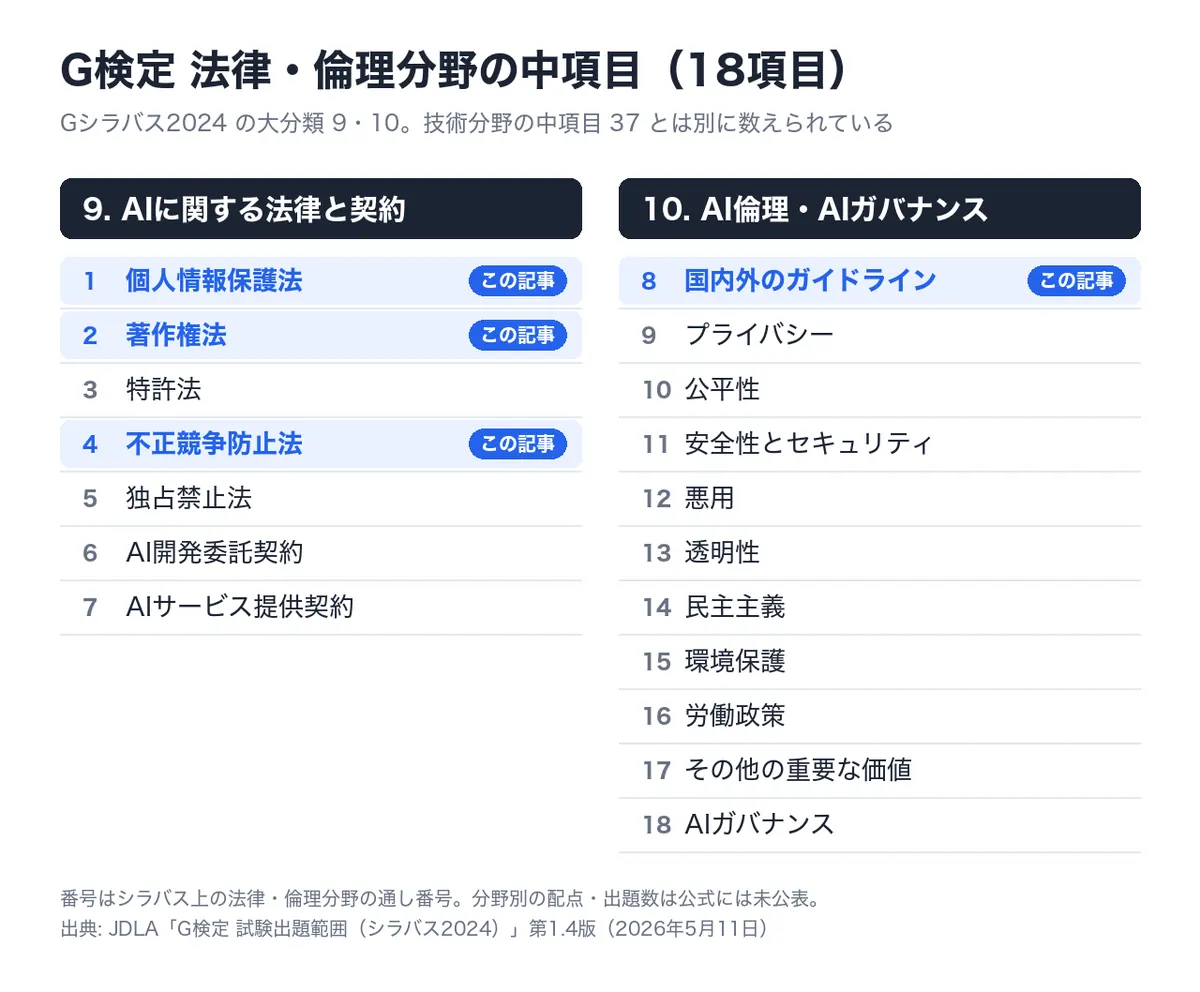
2024年の改訂についてJDLAは、法律・倫理については「ディープラーニングを利活用する方が理解しておくべきポイントを明確に」した、と説明しています(JDLA)。つまり、法律の専門家になるための知識ではなく、AIを作る・使う場面で問題になる点 が問われる、という位置づけです。
18項目をすべて同じ深さで覚える必要はありません。今回は、体験記や対策サイトで繰り返し名前が挙がる 著作権法(30条の4)・個人情報保護法(匿名加工情報と仮名加工情報)・不正競争防止法(営業秘密と限定提供データ)・AI事業者ガイドライン の4つに絞って要点を整理します。
著作権法30条の4:鍵になる言葉は「享受」
生成AIと著作権の話で必ず出てくるのが、著作権法30条の4です。文化庁の文化審議会著作権分科会 法制度小委員会がまとめた「AIと著作権に関する考え方について」(令和6年3月15日)をもとに整理します(文化庁)。
原則:「享受」を目的としない利用は許諾なしでできる
30条の4は、著作物に表現された思想や感情を「自ら享受し又は他人に享受させること」を目的としない利用であれば、必要と認められる限度で、著作権者の許諾なく利用できるとする規定です。同条2号が挙げる「情報解析の用に供する場合」について、文化庁の考え方は AI学習のために行われるものを含め 非享受目的に当たる、と整理しています。
例外1:享受目的が「混じる」と適用されない
試験で狙われやすいのがここです。文化庁の考え方は、一つの利用行為に複数の目的があり、その中に ひとつでも「享受」の目的が含まれていれば、30条の4は適用されない としています。例として挙げられているのは次の2つです。
- 学習データに含まれる著作物の創作的表現を出力させることを目的に、意図的に「過学習」させる追加学習
- ネット上などの著作物の創作的表現を生成AIで出力させる目的で、ベクトルに変換したデータベースを作る場合
例外2:ただし書(著作権者の利益を不当に害する場合)
30条の4には「著作権者の利益を不当に害することとなる場合は、この限りでない」というただし書があります。典型例として示されているのは、情報解析用に整理されて販売されているデータベースの著作物を、情報解析目的で複製する行為 です。
学習段階と生成・利用段階を分けて考える
文化庁の考え方は、場面を「開発・学習段階」と「生成・利用段階」に分けています。30条の4が主に問題になるのは学習の段階です。生成物を出力して使う段階では、AIを使わない創作と同じく、既存の著作物との 類似性と依拠性 が認められれば著作権侵害になり得る、と整理されています。また、作風や画風といったアイデアが似ているだけで、既存の著作物との類似性が認められない生成物は、著作権侵害にはならないとされています。
なお、この文書自体に法的な拘束力は無いことも、文書の冒頭に明記されています。
匿名加工情報と仮名加工情報:「元に戻せるか」で整理する
個人情報保護法では、名前の似た2つの制度の違いがよく問われます。個人情報保護委員会のFAQ(Q14-1)が、違いを直接説明しています(個人情報保護委員会 FAQ)。
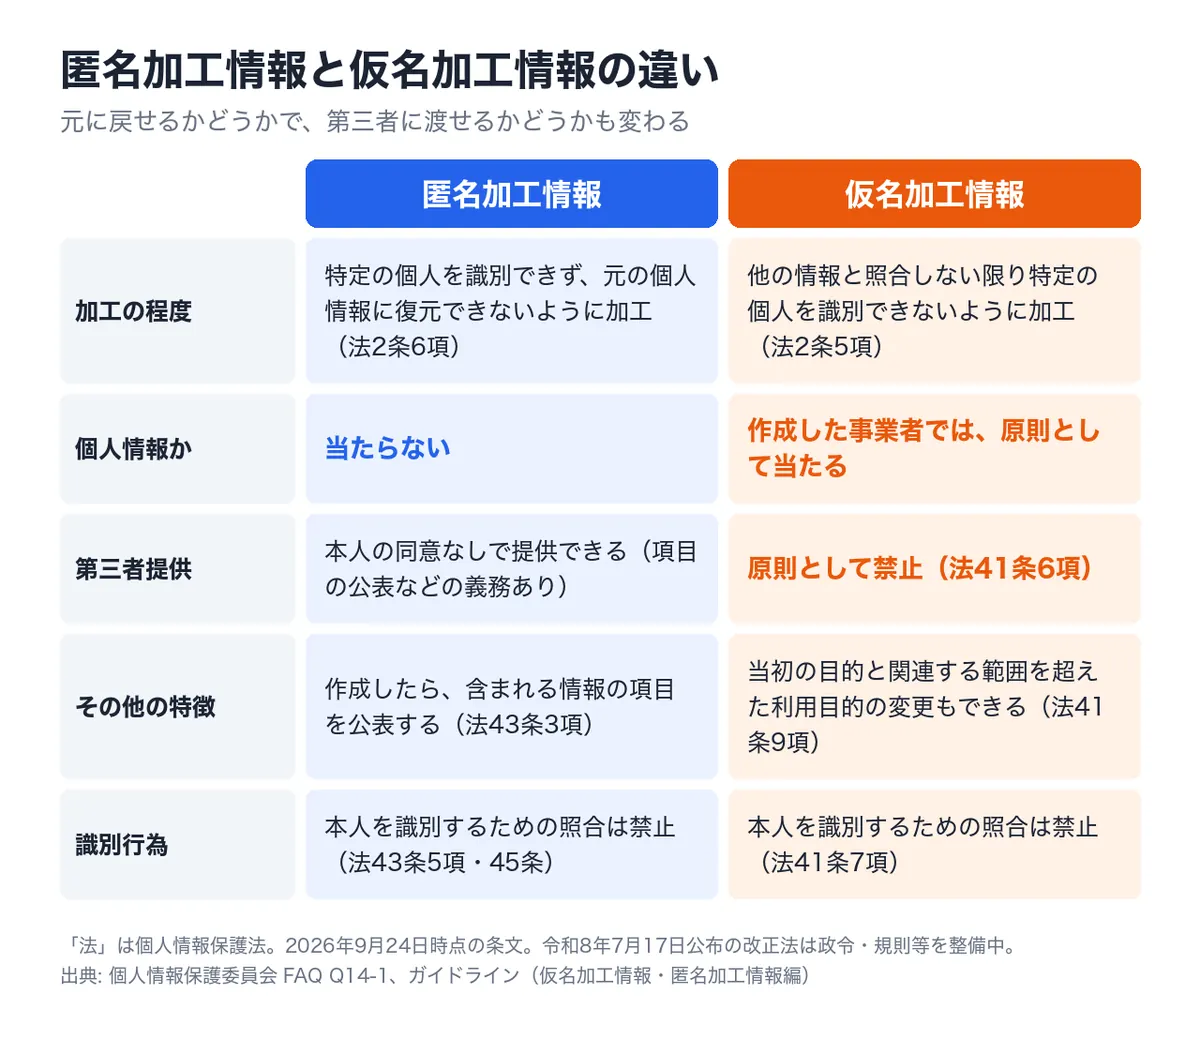
- 匿名加工情報: 特定の個人を識別できず、元の個人情報に 復元できない ように加工したもの。「個人情報」に当たらず、本人の同意を得ずに第三者に提供できる。
- 仮名加工情報: 他の情報と照合しない限り特定の個人を識別できないように加工したもの。作成した事業者は元の個人情報や削除した情報を持っているのが通常なので、原則として「個人情報」に当たる。利用目的の変更は広く認められる一方で、第三者への提供は原則として禁止。
覚え方は単純で、「匿名=元に戻せない代わりに外に出せる」「仮名=社内で分析に使いやすい代わりに外には出せない」です。選択肢で「仮名加工情報は本人の同意なく第三者に提供できる」と書かれていたら誤り、と即答できるようにしておきましょう。
補足として、個人情報保護法は令和8年7月17日に改正法が公布され、現在は政令・規則・ガイドラインの整備が進められています(個人情報保護委員会)。G検定がどの時点の法律を基準に出題するかは公表されていないため、この記事は2026年9月24日時点の条文で説明しています。
営業秘密と限定提供データ:どちらも不正競争防止法
データを守る仕組みとして、不正競争防止法の2つの定義も押さえておきます(e-Gov法令検索 不正競争防止法)。
- 営業秘密(2条6項): 「秘密として管理されている」「事業活動に有用な」「公然と知られていない」技術上・営業上の情報。この3つは一般に 秘密管理性・有用性・非公知性 と呼ばれます。
- 限定提供データ(2条7項): 業として特定の者に提供する情報として、電磁的方法で相当量蓄積され、管理されている技術上・営業上の情報。経済産業省の指針では、要件を 限定提供性・相当蓄積性・電磁的管理性 と整理しています(経済産業省 限定提供データに関する指針)。
見分けるポイントは「秘密にしているか、特定の相手に提供しているか」です。2つの保護が重ならないよう、限定提供データからは営業秘密が除かれています。同じ指針によると、この除外の範囲は制度創設時の「秘密として管理されているものを除く」から、令和5年の法改正で「営業秘密を除く」に改められました。
AIとの関係では、同じ指針が「技術上の情報」の例として 学習用データセットや学習済みモデル を挙げている点が押さえどころです。
AI事業者ガイドライン:版は断定せず、骨格を覚える
国内のガイドラインで中心になるのが、総務省・経済産業省の「AI事業者ガイドライン」です。第1.1版が令和7年3月28日に公表され(総務省)、2026年3月31日には第1.2版が公表されています(経済産業省)。G検定がどの版を出題の基準にしているかは、公式には確認できていません。 シラバスも2024年版のままなので、細かい改訂点を追うより、骨格を押さえるほうが確実です。
第1.1版で確認した骨格は次のとおりです。
- 対象となる主体は AI開発者・AI提供者・AI利用者 の3つ
- 基本理念は、人間の尊厳が尊重される社会、多様な背景を持つ人々が多様な幸せを追求できる社会、持続可能な社会の3つ
- 各主体に共通の指針は、人間中心・安全性・公平性・プライバシー保護・セキュリティ確保・透明性・アカウンタビリティ・教育・リテラシー・公正競争確保・イノベーションの10項目
第1.2版でこの骨格がどう変わったかまでは、この記事では確認していません。受験前に最新版の目次だけでも見ておくと安心です。
体験記から見えた、法律・倫理の攻め方
微妙な問題は深追いしない
法律・倫理の問題は、解釈で迷うものが混じります。2026年5月の会場試験で合格した study.jz5.jp の筆者は、こう書いています。
「法律などの問題には解釈が微妙なものもあるので、「これは微妙だな」と感じた問題は、深追いせず適当に流しておくのがよいです。」
1問あたり約41秒の試験で、1問の解釈に数分かけるのは割に合いません。仮の答えを入れて★チェックを付け、先へ進みましょう。
文系・法務経験者にとっては得点源になる
技術の問題が苦手でも、この分野で点を取れた人がいます。法務経験のある文系の うめか さんは、次のように振り返っています。
「法律・倫理分野は過去の法務業務やコンプライアンス業務でやっていた経験が生きて、軽くなぞる程度で良さそうでした。」
旧シラバス時代ですが、文系のデザイナーが社会実装と倫理・法律系で点を稼げたと振り返る受験記もあります(Yusuke Takami)。
一方で、2026年5月に合格した GMOペパボ たてけん さんは、法律・倫理は問題集ごとの差が大きかったと書いています。問題の言い回しを覚えるのではなく、ここで紹介したような一次資料の言葉で理解しておくと、表現が変わっても対応しやすくなります。この記事で整理した4つの制度の要点なら、問題を解きながら解説で確かめていく形で押さえられます。法律・倫理のために専用の本を別に用意する必要はありません。
問題演習でも、正解を覚えるより「なぜほかの選択肢は違うのか」を確かめるほうが、この分野では効きます。私たちのアプリでも、全問の解説で正解の理由と各選択肢の正誤を読めます。解説に出てくる用語はタップすると専用の用語辞書が開くので、分からない言葉をその場で確かめながら進められます。「享受」や「限定提供性」のように言葉だけでは分かりにくいところは、その問題をそのままAIに質問して、具体例で説明してもらうこともできます。
長い問題文を速く読むための4つのコツ
- 最初に「適切」か「不適切」かを確かめる: 「不適切なものを選べ」を見落とすと、理解していても落とします。study.jz5.jp の筆者は、試験画面で「不適切」が強調表示されていたことで誤答が減ったと書いています。「問題になるものとして不適切」のような言い回しに手こずったという声もありました(Rcat999)。
- キーワードで法律を切り分ける: 「享受」なら著作権法30条の4、「復元」「第三者提供」なら匿名加工情報と仮名加工情報、「秘密として管理」なら営業秘密、「特定の者に提供」「電磁的」なら限定提供データ。どの制度の話かが分かれば、読む範囲がぐっと絞れます。
- 例外の言葉に印を付ける: 「原則として」「ただし」「ひとつでも」のような言葉が、正誤の分かれ目になりやすい部分です。30条の4なら「享受目的が混じると不適用」、仮名加工情報なら「第三者提供は原則禁止」が典型です。
- 本番で調べる前提にしない: 会場試験では私物をロッカーに預けるので、調べることはできません。オンライン試験でも検索は時間を大きく使います(第6回で詳しく書きました)。また、問題文を外部に送信する行為は利用規約で禁じられています(JDLA 利用規約 第8条)。法律の要点は、試験前に頭に入れておくのが一番の時短です。条文や資料を読み込む時間が取れない日は、通勤などのスキマ時間に法律・倫理の問題を数問ずつ解き、間違えた問題だけを繰り返すだけでも、キーワードと制度の結びつきが定着していきます。
まとめ:法律・倫理は「言葉の定義」を押さえれば取れる
- 法律・倫理の分野は 中項目18。まずは著作権・個人情報・不正競争防止法・ガイドラインから
- 著作権法30条の4は 「享受」目的が混じると適用されない。生成・利用段階は 類似性と依拠性 で判断
- 匿名加工情報は同意なしで第三者に提供できる、仮名加工情報は原則として提供できない
- 営業秘密は 秘密管理性・有用性・非公知性、限定提供データは 限定提供性・相当蓄積性・電磁的管理性
- AI事業者ガイドラインは 出題の基準になる版が未確認。3つの主体と10の共通指針を押さえる
- 解釈が微妙な問題は 深追いせず、仮の答えと★チェックで先へ
次回の第9回では、多くの受験者が苦戦するディープラーニングと数理・統計を取り上げ、似た名前のモデルの整理と、統計分野の割り切り方をまとめます。
G検定の500問をアプリで解くなら「ナレッジバンドル」
資格対策アプリ「ナレッジバンドル」には、G検定のオリジナル問題500問がすべて入っています。スキマ時間に1問ずつ解いて、間違えた問題だけを繰り返せます。
- 全問に解説つき。解説の用語はタップでG検定専用の用語辞書が開き、関連用語もたどれる
- 解説を読んでも引っかかったら、その問題をそのままAIに質問。Google検索もワンタップ
- 忘却曲線で復習を自動出題。「間違えた問題だけ」「未回答だけ」「ランダム」など出題の絞り込みも自由
- 本番形式テストで、いまの合格率と弱点カテゴリをグラフで確認
- 広告なし。全教材は無料体験できます
G検定のほか、100以上の資格・検定(レビュー中含む)が1つのアプリで使い放題です。アプリ内の教材追加画面で「G検定」と検索してください。
※この記事は2026年9月24日時点の公開情報をもとにしています。試験の制度や日程は変わることがあるので、受験前に必ずJDLA公式サイトで確認してください。体験記の引用は各記事の原文から行い、リンク先に出典を明記しています。