生成AIパスポート第5章対策:プロンプトの仕組み
生成AIパスポート攻略シリーズの第9回です。この連載では、2025年以降に公開された合格・不合格体験記44本(38人分)を読み込み、主催団体GUGA(一般社団法人 生成AI活用普及協会)の公式情報と突き合わせて、合格に効くやり方を整理しています。
今回は、シラバスの最後の章、第5章「テキスト生成AIのプロンプト制作と実例」 を扱います。ChatGPTやGeminiを毎日使っている人ほど「ここは得意分野」と思いがちな章ですが、体験記を読むと、普段使いの人がいちばん足をすくわれている章 でもあります。
10月試験は、受験期間(10月1日〜31日)に入りました。これから受ける人が、第5章を直前に固めるための要点をまとめます。
私たちは資格の問題集アプリ「ナレッジバンドル」を作っています。体験記を読んで分かったのは、普段使いで何となく分かっている言葉を、試験の言葉で説明できるかどうかが、この章の分かれ目だということでした。生成AIパスポートの520問の解説では、TemperatureやFew-Shotのような用語をタップすると専用の用語辞書が開くようにしているのも、そのためです。
第5章で落とした人、迷った人の声
2026年2月試験で不合格になり、4月試験で合格した 朝岡俊樹さん は、クラウドワークスで案件をこなしていたことから「自分は、普通にできる側でしょ」と思っていたそうです。ところが、試験結果のフィードバックで見た 第5章(プロンプト)の正答率は35% でした。朝岡さんはこう振り返っています。
「“使っている”と“理解している”は、全然違う。」
別の記事では、つまずいた英語の専門用語について「アルファベットの羅列、カタカナの羅列。」と書き、そこを「なんとなく」で流していたことを反省点に挙げています(朝岡俊樹さん)。
合格した人にも、第5章で苦労した声があります。
- 2026年4月試験に合格した リラーニングラボ の筆者は、章別正答率が1〜4章で91〜100%だったのに対し、5章だけ75%。本番でも迷う問題があったとして、「5章は試験直前にもう一度見直すのがおすすめです。」と書いています。
- 2025年6月に不合格、10月に合格した生成AIマスター(nekosanさん)が公開した章別正答率では、5章は不合格時66.67%、合格時55.56%で、どちらの回も5章がいちばん低い数字でした(生成AIマスター)。
同じ傾向は、不合格を経験したほかの人の言葉にも出ています。
生成AIを使いこなしていることと、その仕組みや用語を 4つの選択肢から正しく選べること は、別の力です。第5章はその差がいちばん出やすい章だといえます。
第5章で問われること(シラバスの5項目)
現行シラバス(2026年2月試験以降)で、第5章は次の5つの中項目に分かれています(GUGA 生成AIパスポート試験シラバス)。
- LMとLLM: n-gramモデル、ニューラル言語モデル、LLM、プレトレーニング、ハイパーパラメータ、Temperature、Top-p、プロンプトエンジニアリング
- プロンプティングの基礎: Instruction、Context、Input Data、Output Indicator、Zero-Shot プロンプティング、Few-Shot プロンプティング
- LLMプロンプティングの実践
- テキスト生成AIを用いたビジネス応用
- テキスト生成AIの不得意なこと: 計算、最新の情報、芸術の批評
3と4には、文章の校正・要約、箇条書きと文章の変換、話者の設定の変更、例え話、メールやアンケート項目の作成、タスクの抽出、外国語の翻訳、海外企業宛のメール、ディベート、姓と名の分離、ふりがな、ブレインストーミング、正確な文字数の指定など、具体的な使い方が合わせて20項目以上並んでいます。
3と4は、普段の使い方の延長で答えられる問題が多い項目です。差がつくのは、1(仕組みと用語)と2(プロンプトの型)と5(苦手なこと) です。以下、この3つを中心に見ていきます。
LMとLLM:n-gramからプレトレーニングまで
言語モデル(LM) は、ひと言でいうと「ある単語の並びの次に、どの単語が来やすいか」を確率で表すモデルです。
- n-gramモデル: 直前の n−1 個の単語だけを見て、次の単語の確率を決める古典的な方法です。たとえば2-gram(バイグラム)なら直前の1語だけ、3-gramなら直前の2語だけを見ます。文全体ではなく「すぐ前の数語」で近似するのが特徴です(Jurafsky & Martin『Speech and Language Processing』第3章)。
- ニューラル言語モデル: 同じ「次の単語の予測」を、ニューラルネットワークで行うものです。
- LLM(大規模言語モデル): ニューラル言語モデルを、膨大なパラメータと大量のテキストで大規模にしたものです。GPT-3の論文では、1,750億パラメータのモデルが扱われています(Brown et al. 2020)。
- プレトレーニング(事前学習): 大量のテキストで「次の単語の予測」をあらかじめ学習させる段階です。特定の用途に合わせる前の、土台づくりにあたります。
- ハイパーパラメータ: モデルが学習で身につける値ではなく、人が外から決める設定値のことです。次に説明するTemperatureやTop-pは、文章を生成するときに人が決める設定値の代表例です。
試験で押さえておきたいのは、LLMもn-gramも「次に来る単語の確率を出す」という点では同じ仲間 だということです。この「確率で次の語を選ぶ」という見方が、TemperatureとTop-p、そして後で扱う「苦手なこと」を理解する土台になります。
Temperature と Top-p を仕組みで理解する
LLMは、次に来る単語の候補それぞれに確率を割り当て、その確率に従って1語ずつ選んでいきます。TemperatureとTop-pは、この「選び方」を調整する設定 です。
Temperature:確率の分布を「とがらせる」か「平らにする」か
Temperatureは、候補ごとのスコアを確率に変換する前に、スコアを割る値です(温度つきソフトマックス。考え方は Hinton et al. 2015 などにあります)。
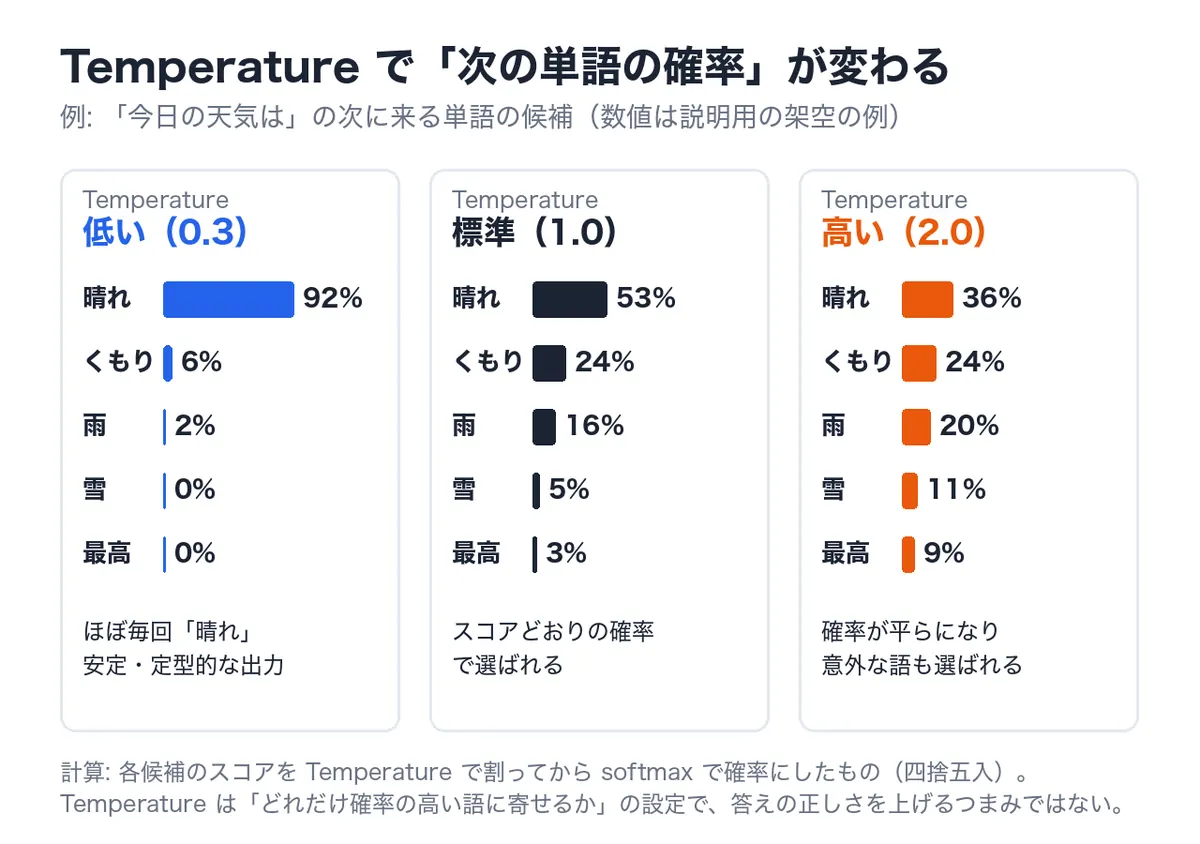
- 低くすると、確率の高い候補にさらに確率が集まり、毎回ほぼ同じ語が選ばれます。出力は安定し、定型的になります。
- 高くすると、確率の差が縮まって分布が平らになり、確率の低い候補も選ばれやすくなります。出力は多様で、意外性のあるものになります。
架空の例で見てみます。「今日の天気は」の次に来る単語の候補を、Temperatureを変えて確率にしたものです。
OpenAIのAPI仕様でも、Temperatureは0〜2の範囲で指定し、0.8のような高い値では出力がよりランダムに、0.2のような低い値ではより焦点の定まった決定的な出力になる、と説明されています(OpenAI API 仕様(openai-openapi))。
用途の目安としては、議事録の要約や定型文のように ぶれてほしくない作業は低め、キャッチコピーやブレインストーミングのように アイデアの幅がほしい作業は高め と覚えておくと、選択肢問題でも判断しやすくなります。
ここで引っかけになりやすいのが、「Temperatureを下げれば答えが正確になる」という誤解 です。Temperatureは「どれだけ確率の高い語に寄せるか」を決めるだけで、モデルが持っていない知識を補ったり、事実の正しさを保証したりするものではありません。もっともらしい誤りを出力する現象(ハルシネーション)は、Temperatureが低くても起こりえます。
Top-p:累積確率で「候補を絞る」
Top-pは、確率の高い候補から順に足していき、合計が p に達したところまでを候補として残し、その中から選ぶ 方法です。ニュークリアス・サンプリング(nucleus sampling)とも呼ばれ、確率の低い「すそ野」の候補を切り捨てることで、多様さを保ちながら不自然な語が出るのを防ぐ手法として提案されました(Holtzman et al. 2019)。
上の図の「標準(1.0)」の例に当てはめると、晴れ53%+くもり24%+雨16%で約92%になります。Top-pを0.9にすると、この3語までが候補に残り、「雪」と「最高」は選ばれなくなります。Top-pを0.1のように小さくすると、ほぼ最上位の1語だけが残ります。OpenAIのAPI仕様でも、0.1は上位10%の確率の範囲にある候補だけを考えるという意味だと説明されています。
TemperatureとTop-pは、どちらも「出力の多様さ」に効く設定です。
- 値を上げる → 多様・ランダム
- 値を下げる → 安定・決定的
という向きは同じです。違いは、Temperatureは確率の分布の形を変え、Top-pは候補の範囲を切る という点です。OpenAIのAPI仕様は、TemperatureかTop-pのどちらか一方を調整し、両方は変えないことを一般的な推奨としています。
プロンプトの4要素:Instruction・Context・Input Data・Output Indicator
シラバスの「プロンプティングの基礎」には、Instruction、Context、Input Data、Output Indicator の4つがキーワードとして並んでいます。これは、プロンプトを構成する要素として広く紹介されている分け方です(DAIR.AI Prompt Engineering Guide「プロンプトの要素」)。
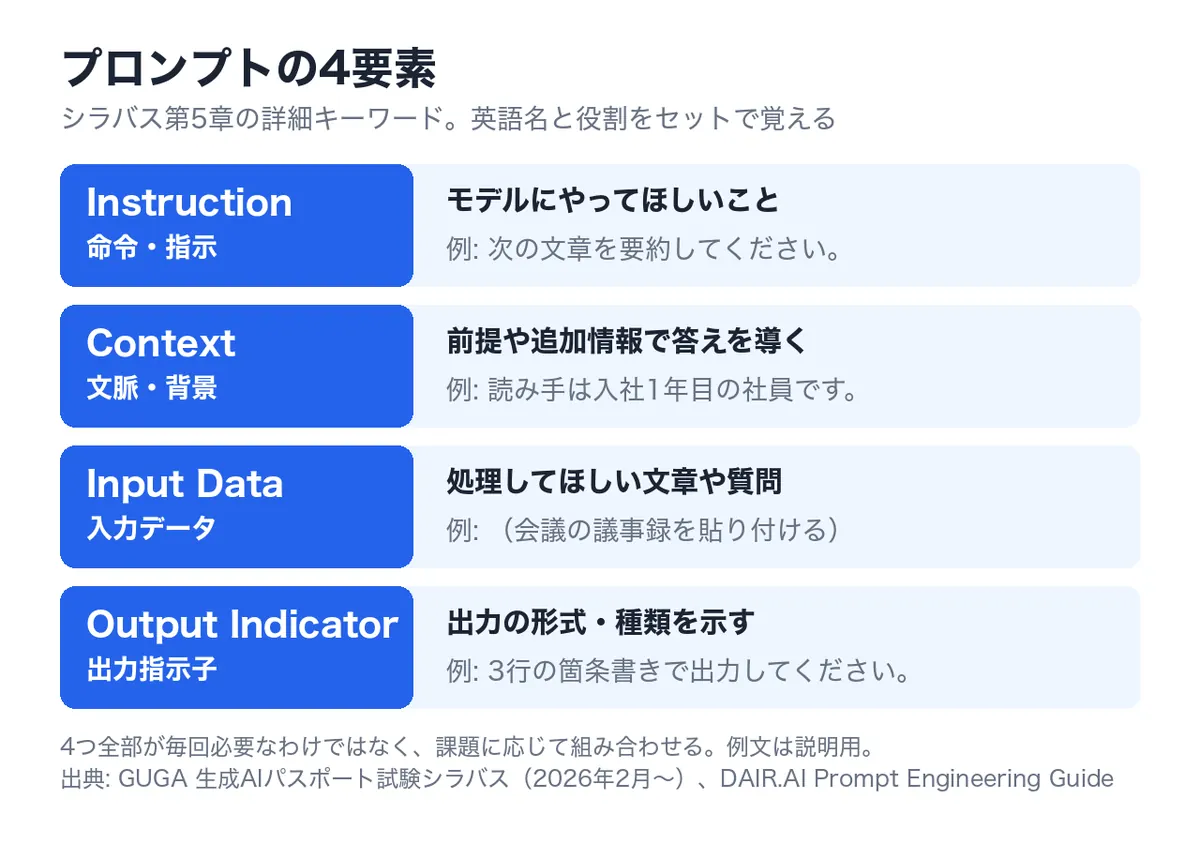
- Instruction(命令): モデルにやってほしい作業。「要約してください」「翻訳してください」
- Context(文脈): 前提や追加の情報。より良い答えに導くための背景。「読み手は入社1年目の社員です」
- Input Data(入力データ): 処理してほしい文章や質問そのもの。貼り付けた議事録、翻訳したい英文など
- Output Indicator(出力指示子): 出力の形式や種類。「3行の箇条書きで」「表形式で」「200字以内で」
試験では、プロンプト例の一部を示して「これはどの要素にあたるか」を問う形が考えられます。迷いやすいのは Context と Input Data の区別です。「処理の対象そのもの」なら Input Data、「処理の仕方に影響する背景」なら Context、と分けて覚えましょう。
もう一つのポイントは、4つ全部が毎回必要なわけではない ことです。DAIR.AIのガイドも「すべてのコンポーネントが必要なわけではなく、フォーマットは手元のタスクに依存します。」と書いています。「4要素がそろっていないプロンプトは使えない」といった選択肢は、疑ってかかってよい表現です。
Zero-Shot と Few-Shot:例を「見せる」かどうか
Zero-Shot と Few-Shot の違いは、プロンプトの中に解き方の例(お手本)を入れるかどうか です。GPT-3の論文では、次のように整理されています(Brown et al. 2020)。
- Zero-Shot: 例を示さず、作業の説明だけで答えさせる
- One-Shot: 例を1つだけ示す
- Few-Shot: 例をいくつか示してから、本番の入力を与える
たとえば、商品レビューを「肯定」「否定」に分ける場合、Zero-Shotなら「次のレビューが肯定か否定か答えてください」とだけ書きます。Few-Shotなら、「とても使いやすい → 肯定」「すぐ壊れた → 否定」のような例をいくつか並べてから、判定したいレビューを渡します。
試験で押さえておきたいのは、次の2点です。
- Few-Shotの「例」は、プロンプトの中で示すだけ です。モデルの重み(パラメータ)を学習し直すわけではありません。GPT-3の論文も、Few-Shotを重みの更新なしで行う設定として扱っています。「Few-Shotでは追加学習(ファインチューニング)を行う」といった選択肢は誤りです。
- Few-Shotは、出力の形式やラベルの付け方をそろえたいとき に向いています。例を見せることで、「どんな形で答えればよいか」がモデルに伝わりやすくなるためです。
ビジネス活用例は「どの要素を足すとよくなるか」で読む
シラバスの「実践」と「ビジネス応用」に並ぶ使い方は、普段から生成AIを使っている人には身近な内容です。
ただし、試験では「使ったことがある」だけでなく、どう指示すればよいか を選ばせる問題が考えられます。そのときに役立つのが、先ほどの4要素です。
- 要約: 何文字・何行で、誰に向けて、という Output Indicator と Context を足すと、狙った要約に近づく
- 校正: 「誤字だけ直す」のか「表現も整える」のか、Instruction を具体的にする。修正箇所を一覧で示させると確認しやすい
- 翻訳・海外企業宛のメール: 相手との関係やフォーマルさの度合いを Context で伝える
- ブレインストーミング: 数と観点を指定する。多様なアイデアがほしい作業なので、Temperatureの考え方でいえば「高め」が合う作業
「LLMがうまく答えないのはモデルが悪いから」ではなく、指示に足りない要素を補う という発想で選択肢を読むと、正解を選びやすくなります。
テキスト生成AIの苦手なこと:計算・最新の情報・芸術の批評
シラバスは、テキスト生成AIの不得意なこととして「計算」「最新の情報」「芸術の批評」の3つを挙げています。公式のサンプル問題にも、テキスト生成AIにできることとして不適切なものを選ぶ問題があり、正解は「正確な情報の抽出」でした(GUGA サンプル問題)。
3つとも、「確率で次の語を選ぶ」という仕組みから理由を説明できます。
- 計算: LLMは数式を計算しているのではなく、次に来そうな文字を選んでいるだけです。桁の多い計算や複雑な計算では、もっともらしい間違った数字を出すことがあります。
- 最新の情報: LLMが知っているのは、プレトレーニングに使ったデータの範囲までです。それより後に起きたことは、そのままでは答えられません(外部の情報を検索して参照させる仕組みが、第3章のRAGです)。
- 芸術の批評: 作品の価値の判断は、人の感性や文脈に大きく左右され、確率的に「それらしい文章」を作ることと、根拠のある評価を下すことは別物です。
この3つをまとめて覚えるなら、「正確さ」「新しさ」「人の感性による判断」が苦手 と整理しておくとよいでしょう。逆に、文章の要約・書き換え・アイデア出しは、シラバスで実践例として挙がっている作業です。
「普段使っている」だけでは取れない理由
ここまで見てきたとおり、第5章で問われるのは、使いこなしのコツよりも 仕組みと用語の説明 です。
- TemperatureやTop-pは、ChatGPTの画面を使っているだけではまず触れない設定です
- Instruction・Context・Input Data・Output Indicator は、知っていても英語名とセットで覚えていないと選べません
- Zero-Shot/Few-Shotは、「例を見せるかどうか」と「学習し直すわけではない」をセットで押さえる必要があります
- 苦手なことは、「なぜ苦手か」まで説明できると、言い回しを変えた選択肢にも対応できます
朝岡さんが立て直しで取り組んだのも、英語の専門用語を一問一答形式で繰り返すことでした。合格者の勉強法でも、用語を自分の言葉で説明できるか を確認する人が多くいます(リラーニングラボの筆者は、用語を見たら一言で説明する練習をすすめています)。
用語を見たら一言で説明するこの練習は、机に向かわなくてもできます。私たちのアプリなら、通勤中などに第5章の問題を解き、解説に出てきた用語をタップして専用の用語辞書で確かめられます。解説を読んでも腑に落ちないときは、その問題をそのままAIに質問することもできます(試験中のAI利用は禁止なので、あくまで勉強中の使い方です)。TemperatureやFew-Shotのような仕組みの話も、解説・用語辞書・AIへの質問がそろっていれば、参考書を別に開かずに問題演習の中で理解まで進められます。
受験期間中の今からできる、第5章の直前チェックは次のとおりです。
- Temperature・Top-pを 上げると多様、下げると安定 と、違い(分布の形か、候補の範囲か)を言えるか
- 4要素の英語名と役割を、プロンプト例を見て当てられるか
- Zero-Shot・One-Shot・Few-Shotを 例の数 で区別し、重みの更新がないことを言えるか
- 苦手な3つ(計算・最新の情報・芸術の批評)を、理由とセットで言えるか
- n-gramが 直前のn−1語 で次の単語を予測することを言えるか
リラーニングラボの筆者のように、ほかの章は取れていても第5章だけ低い、ということは起こります。直前期に一度、本番と同じ形式で通して解き、どこが弱いかを確かめておくと安心です。ナレッジバンドルの本番形式テストでは、いまの合格率と弱点カテゴリをグラフで確認できるので、見直す範囲を絞るのに使えます。
なお、試験中の検索・生成AIの利用・資料の参照・別端末の使用は、公式に禁止されています(GUGA 試験概要)。第5章の用語も、試験中に調べることはできません。また、2026年8月試験では最終日の夜にアクセスが集中して障害が起きました(GUGA)。10月試験の最終日は31日(土)です。日程に余裕を持って受けておきましょう。
まとめ:第5章は「使える」を「説明できる」に変える章
- 第5章は、普段使いの人ほど油断しやすい章。不合格時に第5章が35%だった例もある
- LLMは「次の単語を確率で選ぶ」モデル。n-gramはその古典的な形で、直前のn−1語 だけを見る
- Temperatureは 確率の分布の形、Top-pは 候補の範囲 を変える。どちらも上げると多様、下げると安定。正確さを上げる設定ではない
- プロンプトの4要素は Instruction・Context・Input Data・Output Indicator。全部そろえる必要はない
- Few-Shotは 例をプロンプトで見せるだけ。モデルの学習し直しではない
- 苦手なことは 計算・最新の情報・芸術の批評。理由まで説明できるようにする
連載の最終回となる第10回では、生成AIパスポートに落ちた人の分析をあらためて整理し、試験直前にやることのチェックリストと、合格後に目指す次の資格(G検定・ITパスポート)との違いをまとめます。
生成AIパスポートの520問をアプリで解くなら「ナレッジバンドル」
資格対策アプリ「ナレッジバンドル」には、生成AIパスポートのオリジナル問題520問がすべて入っています。スキマ時間に1問ずつ解いて、間違えた問題だけを繰り返せます。
- 全問に解説つき。解説の用語はタップで生成AIパスポート専用の用語辞書が開き、関連用語もたどれる
- 解説を読んでも引っかかったら、その問題をそのままAIに質問。Google検索もワンタップ
- 忘却曲線で復習を自動出題。「間違えた問題だけ」「未回答だけ」「ランダム」など出題の絞り込みも自由
- 本番形式テストで、いまの合格率と弱点カテゴリをグラフで確認
- 広告なし。全教材は無料体験できます
生成AIパスポートのほか、100以上の資格・検定(レビュー中含む)が1つのアプリで使い放題です。アプリ内の教材追加画面で「生成AIパスポート」と検索してください。
※この記事は2026年9月24日時点の公開情報をもとにしています。試験の制度や日程、禁止事項、シラバスは変わることがあるので、受験前に必ずGUGA公式サイトで確認してください。TemperatureとTop-pの図の数値は、説明のための架空の例です。体験記の引用は各記事の原文から行い、リンク先に出典を明記しています。