生成AIパスポート第1・2章対策:略語とモデル名
生成AIパスポート攻略シリーズの第6回です。この連載では、2025年以降に公開された体験記44本(38人分)を読み込み、主催団体GUGAの公式情報と突き合わせて、合格に効くやり方を整理しています。
今回から4回は、シラバスの章ごとの攻略に入ります。最初は 第1章「AI(人工知能)」と第2章「生成AI(ジェネレーティブAI)」 です。
この2つの章は、体験記で「難しかった」という声がいちばん集まった 略語とモデル名 の章です。逆にいえば、ばらばらに覚えずに 「何をするものか」と「登場した順番」 で整理すれば、得点源にできる章でもあります。
私たちは資格の問題集アプリ「ナレッジバンドル」を作っていて、生成AIパスポートの520問の解説に出てくる略語やモデル名は、タップするとその場で専用の用語辞書が開くようにしています。体験記で「難しかった」の声がいちばん集まったのがこの略語だったので、問題を解く手を止めずに意味を確かめられる形にしました。
なお、10月試験の申込締切は 明日9月30日(水)23:59 です(GUGA 試験概要)。受けるかどうか迷っている人は、先に申込を済ませてからこの記事を読み進めてください。
第1・2章で、受験者は何につまずいたのか
体験記を読むと、第1・2章、とくに第2章でつまずいた声が目立ちます。
- 6月の試験に合格したライターの大橋礼さんは、結果の内訳で 第2章だけが極端に低く、第1章と第4章は9割以上でした。テキスト1冊と気に入った動画に絞った結果、「「わかった気」になってしまっていたようです」と振り返り、似た名前の生成AIで混乱したこと、第2章の暗記ものをもっとやるべきだったことを挙げています(コエテコキャンパス)。
- 2025年10月に合格したakariさんは、RNN・CNN・VAE・GAN、BERT系などの略語を取り違えやすかったと書き、試験には「“似た言葉・近い概念”が混在している」と表現しています(akari)。
- 一度不合格になってから再受験で合格した朝岡俊樹さんは、不合格の原因を「アルファベットの羅列、カタカナの羅列。」と書き、その用語を「なんとなく」で流してしまったと振り返っています(朝岡俊樹)。
- 2026年4月に合格したちーさんは、SoraやGeminiなど 参考書に載っていない実製品についての問題が数問 出たと書いています(東京自習会)。
- 2026年2月に正答率75%で合格したんさんは、生成AIの バージョンの違い を覚えておけばよかったと振り返っています(んのブログ)。
公表されている章別の結果にも、第2章の弱さが出ています。2025年6月に不合格、10月に合格した nekosan さん(模擬試験アプリの開発者で、自作アプリの紹介を含む記事です)は、2回とも第2章が70.59% で変わりませんでした。本人は、問題集の周回で問題文と答えの組み合わせを覚えてしまい、知識の「揺れへの耐性」が足りていない状態だったと分析しています(生成AIマスター)。
章ごとの出題数は公式には公表されていません。ただ、ある合格者は結果画面の正答率から、第1章13問・第2章17問と推計しています(Eto0さん/Qiita)。一人の推計なので目安にとどまりますが、これが近ければ 第1・2章で全60問の半分 にあたります。後回しにできる章ではありません。
第1章「AI」は「区別」と「順番」を押さえる
第1章はAIの基礎です。シラバスには、AIの定義、機械学習の仕組み、AIの種類、AIの歴史、シンギュラリティが並んでいます(GUGA シラバス)。用語の数は多くありませんが、似た用語の区別 と 歴史の順番 がそのまま問題になります。
AIの定義とダートマス会議
「人工知能(Artificial Intelligence)」という言葉は、ジョン・マッカーシーらが1955年に書いた研究計画の提案書で初めて使われ、翌1956年の夏にダートマス大学で研究会(ダートマス会議)が開かれました(Dartmouth)。「AIという言葉が生まれた場」として覚えておきます。
機械学習の種類
AIに知能をもたらす仕組みは、人がルールを書く ルールベース と、データから学ぶ 機械学習 の2つに分けて考えます。機械学習は、次の区別が基本です。
- 教師あり学習: 入力と正解(ラベル)のペアを与えて学習する
- 教師なし学習: 正解を与えず、データ自体のパターンや構造を見つける(クラスタリング・次元削減)
- 強化学習: 行動の結果に報酬を与え、報酬が大きくなる行動を学ぶ
- 半教師あり学習: 正解つきの少量のデータと、正解なしの大量のデータを組み合わせる
公式のサンプル問題3問のうち1問目は、まさに、正解データのペアを与えずにデータ自体のパターンや構造を見つける手法を選ばせる問題で、答えは教師なし学習です(GUGA サンプル問題)。選択肢には「過学習」も並んでいて、用語の区別がそのまま問われます。
過学習と転移学習
- 過学習(オーバーフィッティング): 学習に使ったデータには合いすぎるほど合っているのに、新しいデータではうまく当たらない状態。避ける手法として 正則化 や ドロップアウト がシラバスに載っています
- 転移学習: ある課題で学習済みのモデルを、別の課題に使い回す考え方
弱いAI(ANI)と強いAI(AGI)
ANI(Artificial Narrow Intelligence)は特定の作業に特化したAI、AGI(Artificial General Intelligence)は人間のように幅広い課題をこなせる汎用的なAIです。「N=Narrow(狭い)」「G=General(汎用)」と、略語を元の英語に戻すと取り違えません。
3回のAIブームと「AIの冬」
シラバスのキーワードを順に並べると、次のようになります。
- 第一次AIブーム: 探索・推論
- 第二次AIブーム: エキスパートシステム(専門家の知識をルールとして組み込む)。その後「AIの冬」
- 第三次AIブーム: ビッグデータ・機械学習・ディープラーニング
「どのブームに、どのキーワードが属するか」を入れ替えた選択肢は定番の形です。ブームと冬が交互に来た流れで覚えます。
シンギュラリティ(技術的特異点)
AIが人間の知能を超え、その後の技術の進み方が予測できなくなる時点のことです。シラバスのキーワードは、ヴァーナー・ヴィンジ、レイ・カーツワイル、2045年問題、AI効果です。
- ヴィンジは1993年のエッセイ「The Coming Technological Singularity」でこの考えを広めました(Vinge 1993)
- カーツワイルは、シンギュラリティが2045年に来ると予測した人物として知られています(「2045年問題」)
- AI効果 は、ある技術が実現して仕組みがわかると、もう知能とは見なされなくなる現象です
第2章① 生成モデルの仕組みは「正式名称+一行」で覚える
第2章は、生成AIが生まれるまでの技術と、ChatGPTを中心としたモデル・製品の章です。前半の技術の略語は、正式名称に戻して、何をする仕組みかを一行で言える ようにするのが近道です。以下は原論文で確認した内容です。
- VAE(変分自己符号化器): エンコーダ で入力を 潜在ベクトル に圧縮し、デコーダ で復元・生成する(Kingma & Welling, 2013年、arXiv:1312.6114)
- GAN(敵対的生成ネットワーク): 本物そっくりのデータを作る 生成器 と、本物か偽物かを見分ける 識別器 が競い合って学習する(Goodfellow ほか, 2014年、arXiv:1406.2661)
- RNN(回帰型ニューラルネットワーク): 文章や音声のような 順番のあるデータ(シーケンスデータ) を、前の時点の情報を受け渡しながら順に処理する
- LSTM(長・短期記憶): RNNの改良版。長い系列で情報が失われる問題に対処した(Hochreiter & Schmidhuber, 1997年、Neural Computation)
- Transformer: RNNや畳み込みを使わず、Attention(注意機構) だけで系列を処理するモデル。文中の単語どうしの関係を見る Self-Attention(自己注意) と、語順の情報を加える 位置エンコーディング が要点(Vaswani ほか, 2017年、論文名は「Attention Is All You Need」、arXiv:1706.03762)
Transformerの後に生まれた言語モデルは、GPTとBERTの対比 が軸です。
- GPT(OpenAI): 大量の文章で事前学習し、個別の課題に合わせてファインチューニングする2段階の方式(OpenAI 2018)。次の単語を予測する ことで文章を生成する
- BERT(Google): 文の前後の両方向から文脈を読む 双方向 のモデル。MLM(文中の一部の単語を隠して当てる)と NSP(2つの文が続いているかを当てる)で事前学習する(Devlin ほか, 2018年、arXiv:1810.04805)
- RoBERTa・ALBERT: どちらもBERTの改良版(RoBERTa、ALBERT)。ALBERTの名前は「A Lite BERT」の略で、軽量化したBERTです
ChatGPTの仕組みに関わる用語も、ここでまとめて押さえます。
- RLHF(人間のフィードバックによる強化学習): 人が出力を比べて順位をつけたデータで、モデルをさらに調整する方法。InstructGPTの論文では、13億パラメータのInstructGPTの出力が、100倍以上大きい1,750億パラメータのGPT-3の出力より好まれたと報告されています(arXiv:2203.02155)
- アライメント: AIの振る舞いを、人間の意図や価値観に沿わせること。RLHFはそのための手法の一つです
- ファインチューニング: 事前学習したモデルを、特定の目的のデータで追加学習すること
- ハルシネーション: もっともらしいが事実と異なる内容を出力する現象
- マルチモーダル: テキスト・画像・音声など、複数の種類のデータを扱えること
第2章② GPTの系譜と各社のモデル名は「年表」で覚える
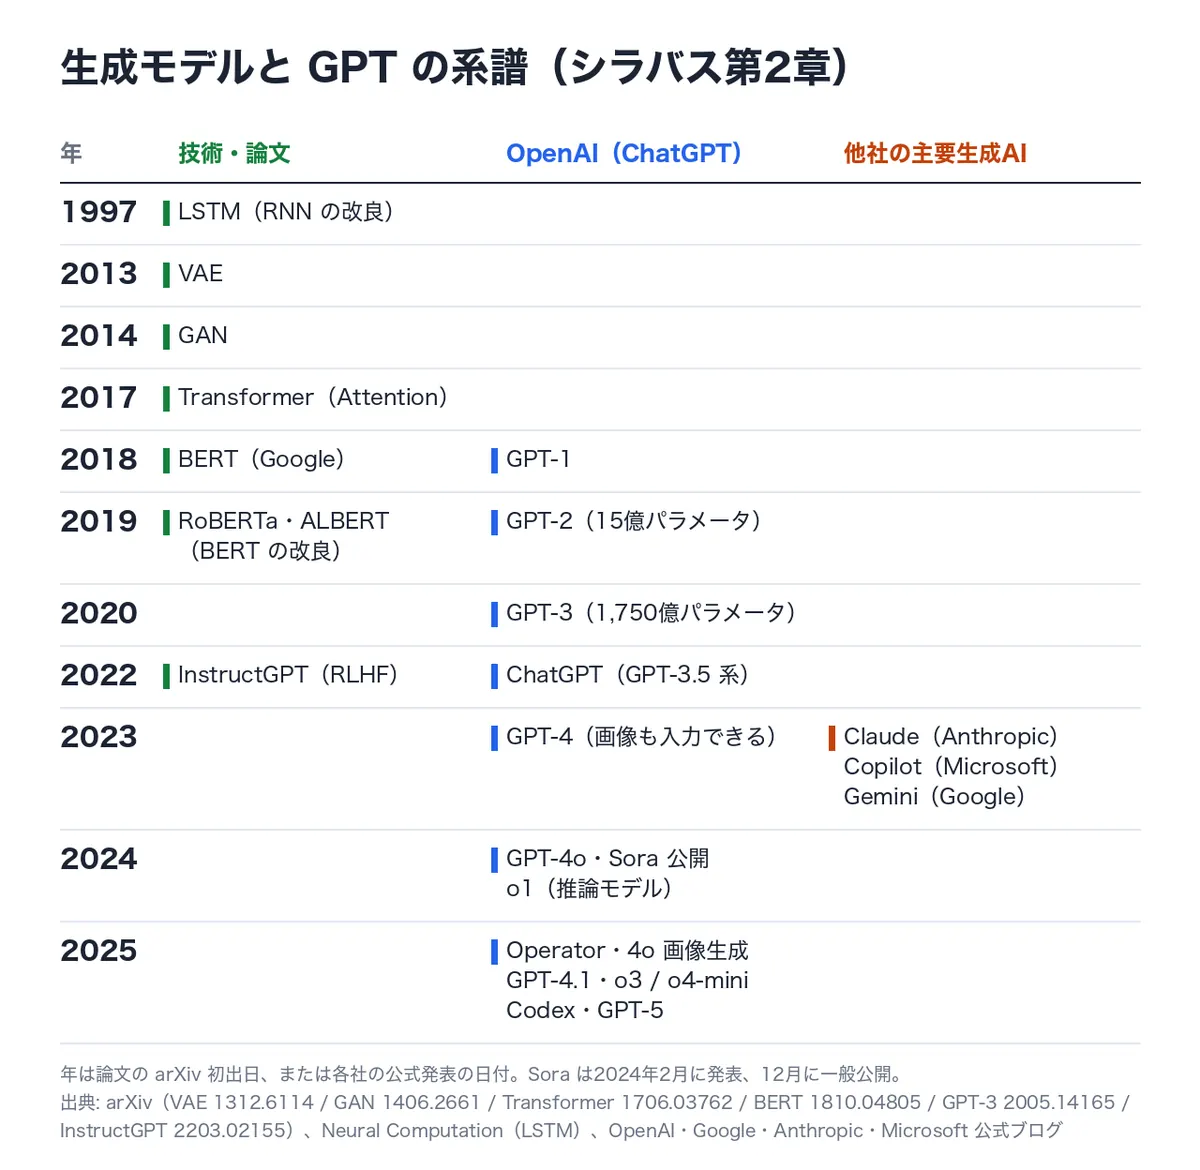
2026年2月試験から適用の現行シラバスでは、第2章に GPT-o1・GPT-o3・GPT-o4、GPT-4.1、GPT-5、Operator、Codex、Image Generation、Gemini、Claude、Copilot が追加されました(GUGA シラバス 改訂内容)。古い教材には載っていない名前です。まず全体を系譜図で見てください。
OpenAIのGPT:数字は「規模と能力の世代」
- GPT-1(2018年): Transformerで事前学習+ファインチューニングの方式を示した最初のGPT
- GPT-2(2019年): 15億パラメータ。悪用の懸念から、大きいモデルを段階的に公開しました(OpenAI)
- GPT-3(2020年): 1,750億パラメータ。少数の例を見せるだけで課題をこなす能力を示しました(arXiv:2005.14165)
- InstructGPT・GPT-3.5(2022年): RLHFで人の指示に従うよう調整。ChatGPT(2022年11月公開)はGPT-3.5系のモデルをRLHFで調整したものです(OpenAI)
- GPT-4(2023年3月): 画像とテキストを入力でき、テキストで答えるマルチモーダルなモデル(OpenAI)
- GPT-4o(2024年5月): 「o」は omni(すべて)の意味。テキスト・音声・画像を1つのモデルでまとめて扱います(OpenAI)
- GPT-4.1(2025年4月): API向けのモデル群で、コーディングと長い文脈の理解を強化しました(OpenAI)
- GPT-5(2025年8月): 速く答えるモデルと、深く考える推論モデル(GPT-5 thinking)を、質問に応じて自動で切り替える仕組みを持つシステムとして発表されました(OpenAI)
「o」がつく名前が2種類ある
いちばん取り違えやすいのがここです。
- GPT-4o の「o」は omni。マルチモーダルの話です
- o1・o3・o4-mini は、答える前に時間をかけて考える推論モデル(oシリーズ)です。o1は2024年9月、o3とo4-miniは2025年4月に発表されました(OpenAI o1、OpenAI o3・o4-mini)
なお、シラバスは「GPT-o1」「GPT-o3」「GPT-o4」と書いていますが、OpenAIの正式な呼び方は「OpenAI o1」「o3」「o4-mini」です。o4として公開されたのは、小型版の o4-mini です。問題文ではどちらの表記でも出うるので、同じものだとわかるようにしておきましょう。
ChatGPTの機能・製品
- Code Interpreter: ChatGPTの中でPythonのコードを実行して、データ分析やグラフ作成などをする機能
- GPTs: 用途に合わせて、自分専用にカスタマイズしたChatGPTを作れる機能(OpenAI)
- Image Generation: 2025年3月に、GPT-4oに組み込まれた画像生成として発表されました(OpenAI)
- Sora: テキストから動画を作る動画生成AI。2024年2月に発表、12月に一般公開されました(OpenAI)。ただしOpenAIのヘルプセンターによると、Soraのウェブ版とアプリは2026年4月に提供を終えています(OpenAI Help)。試験では、シラバスどおり「OpenAIの動画生成AI」として覚えておけば足ります
- Operator: 2025年1月に発表された、専用のブラウザを見て、入力・クリック・スクロールをしながらWeb上の作業を代行する エージェント(OpenAI)。その後、ChatGPTのエージェントモード(ChatGPT agent)に統合されています(OpenAI Help)
- Codex: 2025年5月に研究プレビューとして発表された、機能の追加やバグの修正などを並行してこなす ソフトウェア開発のエージェント(OpenAI)
OpenAI以外の主要な生成AI
シラバスの第2章は、ChatGPT以外の主要なテキスト生成AIとして3つを挙げています。問われやすいのは 「どの会社のものか」 です。
- Gemini: Google。2023年12月に、最初からテキスト・画像・音声・動画などを扱えるように作られたマルチモーダルなモデル群として発表されました(Google)
- Claude: Anthropic。2023年3月に、役に立ち、正直で、無害なAIを目指す研究にもとづくAIアシスタントとして公開されました(Anthropic)
- Copilot: Microsoft。2023年11月に、Bing ChatがCopilotに名前を変えました(Microsoft)
各社とも、このあとも新しいバージョンを次々に出しています(OpenAIもGPT-5のあとにGPT-5.x系を出しています)。試験の基準はシラバスなので、シラバスに載っている名前と、その会社・用途 を優先して押さえましょう。
体験記から見えた、略語とモデル名の覚え方
1. 略語は「正式名称」に戻し、かみくだいて説明させる
非情報系の仕事をしながら合格したpisuke9190さんは、CNN・RNN・VAEなどの略語をGeminiに「高校生でもわかるように」説明させた方法について、「一番これが効いたかもしれません。」と書いています(はてなブログ)。
ただし、一度落ちてから合格した介護福祉士のキム・タックさんは、AIが自信満々に間違えることがあるので鵜呑みにしないよう注意しています(キム・タック)。AIの説明は入口として使い、最後は問題の解説と用語の定義で確かめる のが安全です。私たちのアプリでは、問題演習の途中で引っかかった用語をその問題ごとAIに質問でき、AIの答えを、全問についた解説と専用の用語辞書の定義にその場で突き合わせられます。「AIでかみくだく → 解説と辞書で確かめる」が1つのアプリの中で済むので、参考書を別に開く必要はありません。
2. 似た名前は「対」にして、一行で違いを言う
akariさんが書いたとおり、この試験は似た言葉・近い概念を入れ替えた選択肢で差がつきます。1つずつ覚えるより、並べて違いを言える形 にしておくほうが、選択肢のすり替えに気づけます。
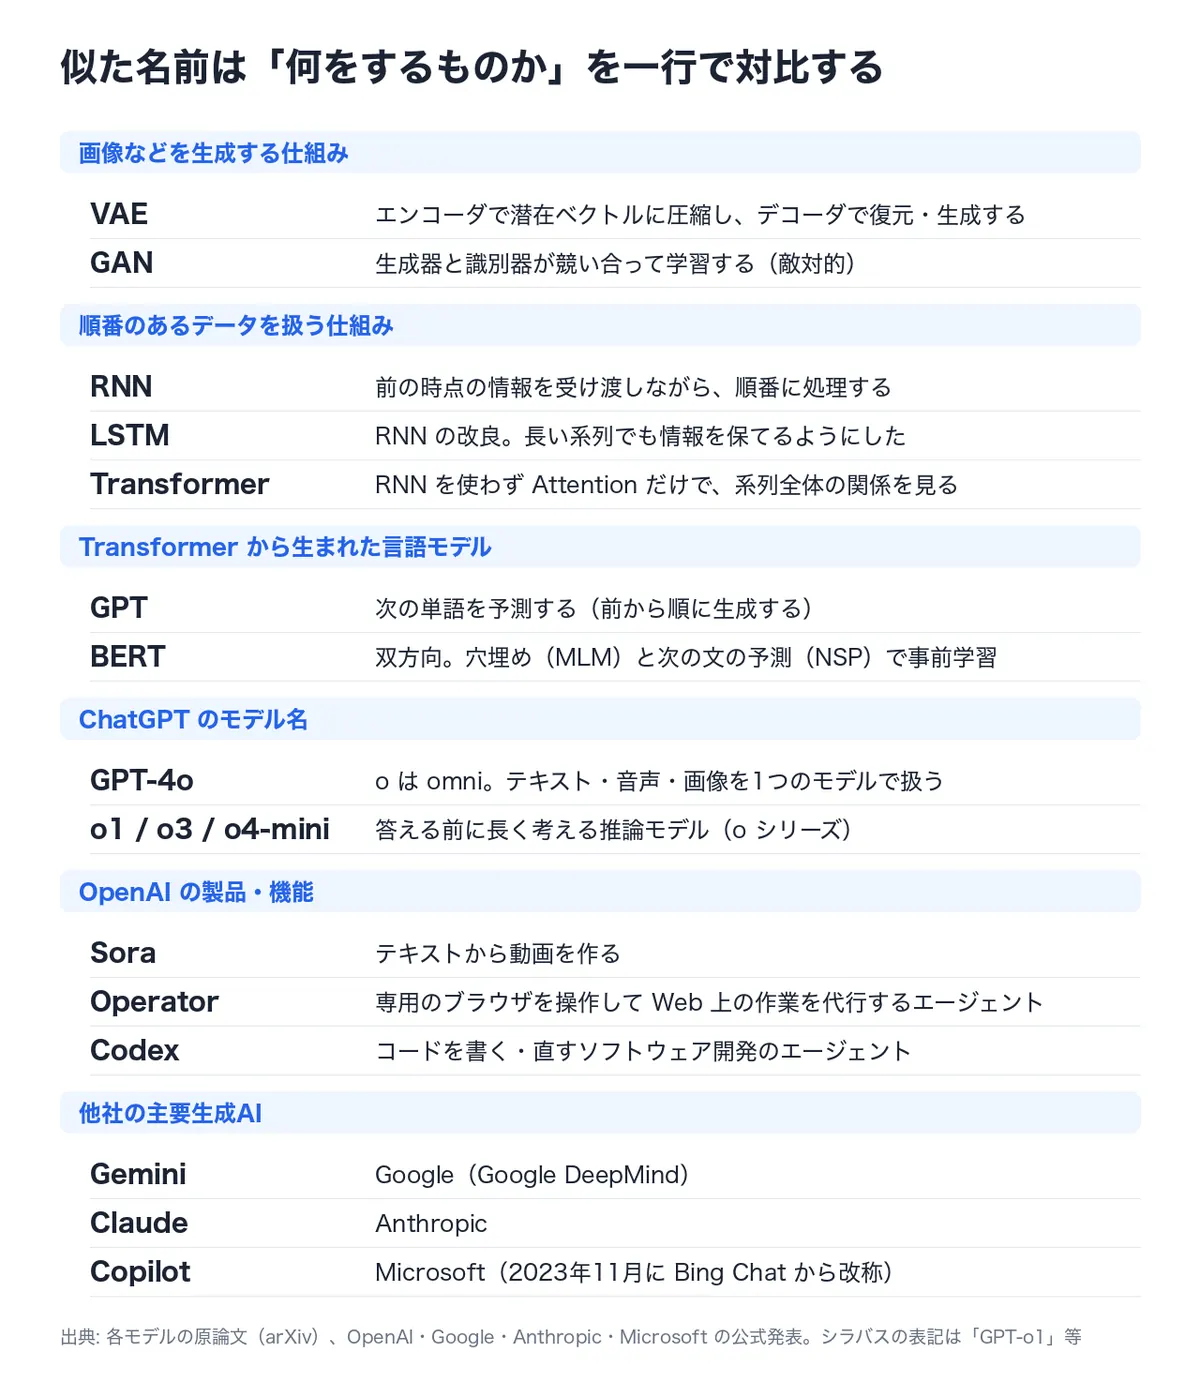
この図の右側を隠して、左の名前から一行で説明できるかを試してみてください。説明できなかったものが、解説と用語辞書で確かめ直すべき箇所です。
3. 順番は系譜図で覚え、違う聞かれ方の問題に触れる
モデル名は、系譜図の 「年」と「会社」 に結びつけると忘れにくくなります。GPT-4 → GPT-4o → o1 → GPT-4.1 → GPT-5 のように、前後関係がわかっていれば「GPT-3より前にRLHFで調整されたChatGPTが出た」といった誤りの選択肢にも気づけます。
そのうえで、大橋さんやnekosanさんの例が示すように、同じ問題集を繰り返すだけ では、言い回しが変わった問題に弱くなります。同じ問題を答えを覚えるまで回すのではなく、同じ用語を違う角度から聞く問題に数多く触れ、選択肢ごとの解説で「なぜ違うか」まで確かめる ことが大切です。
この「違う角度の問題」は、通勤や休み時間のようなスキマ時間に回すのが向いています。アプリで演習するなら、答えの番号ではなく解説まで読むのが前提です。ナレッジバンドルでは全問に、正解の理由と各選択肢の正誤の解説がついていて、解説に出てくる用語をタップすると専用の用語辞書が開きます。第1・2章の略語やモデル名は、この「解いて、解説を読んで、辞書で引く」の繰り返しだけで理解まで進められます。VAE と GAN、GPT と BERT のように取り違えた組は、「間違えた問題だけ」に絞って出し直すと、苦手な対だけを集中して確認できます。
なお、生成AIパスポートの試験中は、資料の閲覧や検索、AIツールの利用、別の端末の使用がすべて禁止されています(GUGA 試験概要)。1問60秒の試験で、モデル名をその場で確かめる手段はありません。頭の中の系譜図だけで答えられる状態 を目指しましょう。
まとめ:第1・2章は「一行説明」と「年表」で取る
- 第1・2章は、体験記で「難しかった」という声がいちばん集まった 略語とモデル名 の章。ある合格者の推計では、2章で全体の約半分を占める
- 第1章は 区別(教師あり/なし/強化学習、ANI/AGI、過学習/転移学習)と 順番(3回のAIブームと冬)
- 第2章の技術は 正式名称+一行(VAE・GAN・RNN・LSTM・Transformer・GPT・BERT・RLHF)
- モデル名は 系譜図の年と会社 で覚える。GPT-4oの「o」とoシリーズは別物
- AIの説明は入口として使い、最後は問題の解説と用語辞書の定義で確かめる。言い回しの違う問題にも触れる
10月試験の申込は 明日9月30日(水)23:59まで です。受験期間は10月1日(木)から31日(土)までで、最終日の夜は混み合った前例があるので避けたほうが安全です。
連載の第7回は、第3章「現在の生成AIの動向」を取り上げます。2026年のシラバス改訂で加わったRAG・AIエージェント・MCPと、ディープフェイクの要点を整理します。
生成AIパスポートの520問をアプリで解くなら「ナレッジバンドル」
資格対策アプリ「ナレッジバンドル」には、生成AIパスポートのオリジナル問題520問がすべて入っています。スキマ時間に1問ずつ解いて、間違えた問題だけを繰り返せます。
- 全問に解説つき。解説の用語はタップで生成AIパスポート専用の用語辞書が開き、関連用語もたどれる
- 解説を読んでも引っかかったら、その問題をそのままAIに質問。Google検索もワンタップ
- 忘却曲線で復習を自動出題。「間違えた問題だけ」「未回答だけ」「ランダム」など出題の絞り込みも自由
- 本番形式テストで、いまの合格率と弱点カテゴリをグラフで確認
- 広告なし。全教材は無料体験できます
生成AIパスポートのほか、100以上の資格・検定(レビュー中含む)が1つのアプリで使い放題です。アプリ内の教材追加画面で「生成AIパスポート」と検索してください。
※この記事は2026年9月24日時点の公開情報をもとにしています。試験の制度や日程、シラバスは変わることがあるので、受験前に必ずGUGA公式サイトで確認してください。技術やモデルの説明は各論文と各社の公式発表で確認しています。体験記の引用は各記事の原文から行い、リンク先に出典を明記しています。